 Skip to main content

Tomasz Węgrzyn, Head of Operational Technology Unit, ConnectPoint
Kiedy rozmawiam z klientami o AVEVA PI System, rzadko zaczynam od liczby tagów, wersji serwera czy architektury kolektorów. Znacznie bardziej interesuje mnie odpowiedź na pytanie: czego chcielibyście dowiedzieć się o swojej instalacji, czego obecnie nie jesteście w stanie sprawdzić w ciągu kilku minut?
Odpowiedzi są podobne w bardzo różnych branżach. Ile energii zużywamy na tonę produktu i skąd wynikają różnice pomiędzy zmianami? Które pompy pracują poza optymalnym zakresem? Ile trwały rozruchy kotła w ostatnim kwartale i jakie parametry odróżniały najkrótsze od najdłuższych? Które odchylenia poprzedzały awarie urządzeń?
Dane potrzebne do takich analiz często już istnieją. Znajdują się w sterownikach PLC, systemach SCADA i DCS, a w wielu przedsiębiorstwach również w wieloletnim archiwum PI. Problem zaczyna się wtedy, gdy użytkownik widzi tysiące szeregów czasowych, lecz nie ma spójnego modelu pokazującego, do jakich urządzeń i procesów należą, w jakich warunkach powstały oraz jak należy je interpretować.
W aktualnym portfolio AVEVA PI System pozostaje rozwijanym środowiskiem do zarządzania danymi operacyjnymi. Producent oferuje go obecnie także w ramach AVEVA PI Data Infrastructure, która rozszerza architekturę PI o zarządzanie danymi od edge, przez instalacje on-premises, po usługi CONNECT. Dla organizacji posiadającej PI Server oznacza to możliwość dalszego rozwijania istniejącego środowiska i udostępniania danych w architekturach hybrydowych.
Archiwum danych jest jedną z warstw dobrze zaprojektowanego PI System
PI System jest często utożsamiany z historianem, ponieważ PI Data Archive odpowiada za przechowywanie szeregów czasowych. W rzeczywistym środowisku przemysłowym archiwizacja stanowi część większego przepływu danych obejmującego ich pozyskanie, przechowywanie, kontekstualizację, obliczenia, wizualizację i wymianę z innymi aplikacjami.
Aktualne portfolio AVEVA dobrze pokazuje ten podział:
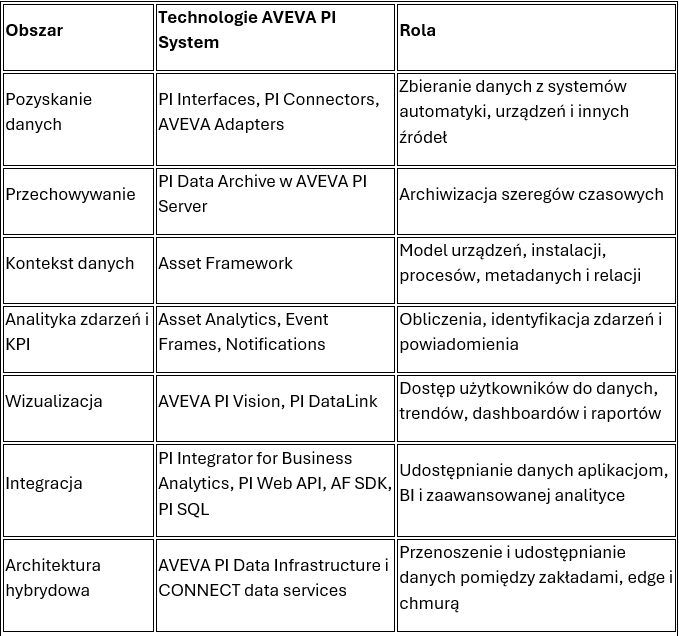
PI Interfaces, PI Connectors oraz AVEVA Adapters pozostają częścią aktualnej oferty AVEVA dotyczącej akwizycji danych, podobnie jak PI Vision, PI DataLink i PI Integrator for Business Analytics po stronie wykorzystania danych.
Na etapie akwizycji i archiwizacji duże znaczenie mają ustawienia określające, które wartości rzeczywiście trafiają dalej. W klasycznych architekturach PI mechanizm exception reporting jest związany przede wszystkim z warstwą pozyskiwania danych, natomiast compression ogranicza liczbę zdarzeń zapisywanych w archiwum. Ustawienia tych mechanizmów muszą wynikać z charakteru konkretnego sygnału. Zbyt duża tolerancja może ograniczyć widoczność krótkich zmian istotnych dla późniejszej analizy, a zbyt zachowawcza konfiguracja prowadzi do przechowywania dużej liczby danych, które nie wnoszą dodatkowej informacji.
Największą zmianę w sposobie wykorzystania PI System obserwuję jednak zwykle wyżej, na poziomie kontekstu.
Asset Framework zamienia listę tagów w model instalacji
Informacja, że temperatura w danym momencie wynosiła 87°C, ma ograniczoną wartość bez wiedzy o tym, czego dotyczył pomiar. Ta sama wartość może występować podczas normalnej pracy urządzenia, przy rozruchu, obniżonym obciążeniu albo w okresie, kiedy maszyna powinna być wyłączona.
Do interpretacji potrzebny jest kontekst: urządzenie, stan pracy, obciążenie, receptura lub produkt, parametry nominalne oraz zachowanie tego samego obiektu w porównywalnych warunkach.
Asset Framework, czyli AF, pełni w PI Server rolę modelu danych operacyjnych. Pozwala odwzorować strukturę znaną użytkownikom zakładu: przedsiębiorstwo, lokalizację, wydział, linię, urządzenie i jego podzespoły. Hierarchia może być dopasowana do modelu majątku stosowanego w przedsiębiorstwie, w tym do struktur zbliżonych do ISA-95, jeżeli organizacja wykorzystuje taki sposób klasyfikacji.
Szczególnie użyteczne są szablony elementów. Szablon pompy odśrodkowej może definiować wspólny zestaw atrybutów: przepływ, ciśnienie ssania i tłoczenia, temperatury, pobór mocy, stan pracy, parametry nominalne i wartości obliczane. Atrybuty dynamiczne mogą wskazywać konkretne PI Points, natomiast część informacji może pochodzić z innych źródeł albo być wynikiem obliczeń.
Model utworzony raz dla danej klasy urządzenia można później stosować do kolejnych obiektów. Dzięki temu definicja KPI, analizy czy sposobu prezentacji danych nie musi być odtwarzana oddzielnie dla każdej pompy, sprężarki lub wymiennika. AVEVA wskazuje hierarchie, modele i szablony Asset Framework jako mechanizm organizowania oraz kontekstualizacji danych w PI Server.
Z perspektywy użytkownika różnica jest zasadnicza. Technolog zaczyna pracować z pojęciem „Pompa P-101” zamiast z listą tagów o nazwach, które zna przede wszystkim automatyk. Utrzymanie ruchu, produkcja i energetyka mogą korzystać z tych samych definicji urządzeń i wskaźników, co ogranicza powstawanie równoległych arkuszy kalkulacyjnych zawierających inne wersje tych samych obliczeń.
Asset Analytics i Event Frames pozwalają analizować proces w kontekście zdarzeń
Kolejnym krokiem jest przejście od obserwacji pojedynczych wartości do analizy tego, co dzieje się z urządzeniem lub procesem.
Asset Analytics umożliwia wykonywanie obliczeń strumieniowych na danych PI Server i przeliczanie historii. W ten sposób można tworzyć KPI takie jak jednostkowe zużycie energii, dostępność, sprawność, liczba cykli czy czas pracy urządzenia. Definicja umieszczona w szablonie AF może być stosowana do całej klasy urządzeń, dzięki czemu sposób obliczania wskaźnika pozostaje spójny. Aktualna dokumentacja produktowa AVEVA nadal wskazuje możliwość tworzenia analiz opartych na szablonach oraz wykonywania backfillu dla danych historycznych.
Inny sposób patrzenia na proces wprowadzają Event Frames. Pozwalają zapisać okres posiadający początek, koniec oraz zestaw powiązanych danych. Może to być rozruch, postój, batch produkcyjny, przekroczenie parametru, zadziałanie zabezpieczenia albo okres pracy w określonym stanie.
Przykład w praktyce
Jeżeli każdy rozruch kotła zostanie zapisany jako Event Frame, można porównać setki rozruchów według czasu trwania, zużycia paliwa, temperatur, ciśnień i innych parametrów procesowych. Analiza przestaje wymagać ręcznego wybierania zakresów czasu na trendzie. Użytkownik pracuje na zbiorze porównywalnych zdarzeń i może sprawdzić, jakie warunki występowały podczas rozruchów najlepszych oraz najbardziej problematycznych.
AVEVA opisuje Event Frames właśnie jako mechanizm identyfikowania i rejestrowania powtarzalnych zdarzeń posiadających czas rozpoczęcia i zakończenia, takich jak batch, zmiana, rozruch czy przestój.
W tym momencie historia procesu zaczyna odpowiadać na pytania operacyjne. Użytkownik może analizować liczbę zdarzeń, ich czas trwania, warunki wystąpienia oraz zależności pomiędzy nimi, zamiast przeglądać oddzielnie dziesiątki trendów.
Jakość danych decyduje o wiarygodności zaawansowanej analityki
W działających od wielu lat środowiskach PI regularnie pojawiają się problemy, które są mało widoczne podczas codziennego przeglądania trendów. Należą do nich tagi bez aktualnych opisów i jednostek, niewłaściwie dobrane ustawienia exception i compression, zamrożone wartości z odłączonych czujników, błędne stany jakości, przesunięcia timestampów oraz kilka punktów reprezentujących ten sam pomiar.
Takie problemy stają się znacznie bardziej widoczne, gdy dane zaczynają zasilać automatyczne KPI, porównania wielu urządzeń albo modele analityczne. Matematycznie poprawna kalkulacja wykonana na nieprawidłowym sygnale nadal daje nieprawidłowy rezultat.
Szczególnie istotne jest to przy Predictive Maintenance i uczeniu maszynowym. W przypadku modeli nadzorowanych oznaczone przykłady zdarzeń i awarii mogą być bardzo wartościowym materiałem treningowym. Metody detekcji anomalii mogą działać także bez dużej liczby oznaczonych awarii, lecz nadal wymagają reprezentatywnych danych z normalnej pracy, prawidłowego kontekstu operacyjnego oraz późniejszej walidacji wyników przez ekspertów.
Event Frames mogą tutaj pełnić dodatkową rolę. Jeżeli organizacja konsekwentnie rejestruje postoje, alarmy, remonty, rozruchy i inne zdarzenia, uzyskuje uporządkowane przedziały czasowe, które można wykorzystać podczas przygotowania oraz walidacji analiz.
Sam PI System dostarcza dane, kontekst i mechanizmy obliczeniowe. Zaawansowane zastosowania predykcyjne mogą korzystać z dodatkowych narzędzi. AVEVA Predictive Analytics pozostaje osobnym produktem AVEVA zintegrowanym z PI System, oferującym między innymi detekcję anomalii i prognozowanie czasu do potencjalnej awarii. Dane PI można również udostępniać własnym modelom i zewnętrznym platformom analitycznym.
Dlatego przed rozpoczęciem projektu AI opłaca się sprawdzić jakość danych wcześniej niż sam model. Jeżeli technolog, automatyk i użytkownik biznesowy różnie interpretują ten sam tag, problem znajduje się w warstwie danych i kontekstu.
Dane z PI System można udostępniać dalej bez przebudowy istniejącego środowiska
Dojrzałe wykorzystanie PI System często prowadzi do sytuacji, w której dane potrzebne są także poza środowiskiem OT: w raportowaniu biznesowym, aplikacjach własnych, Data Lake, systemach AI, CMMS, ERP albo rozwiązaniach chmurowych.
AVEVA nadal rozwija kilka sposobów realizacji takiego dostępu.
PI Integrator for Business Analytics przygotowuje dane PI Server do wykorzystania przez narzędzia BI i zaawansowanej analityki. Pozwala wybierać, oczyszczać i kształtować dane w tabelaryczne zbiory wraz z zachowaniem kontekstu pochodzącego z PI Server. Produkt pozostaje elementem aktualnego portfolio AVEVA.
Własne aplikacje mogą korzystać z PI Web API, AF SDK oraz PI SQL. PI Web API udostępnia dane szeregu czasowego, metadane aktywów i zdarzenia poprzez REST, AF SDK pozwala aplikacjom .NET pracować bezpośrednio z modelem Asset Framework, a PI SQL daje możliwość wykonywania zapytań do danych PI przy użyciu mechanizmów znanych z relacyjnych baz danych. Wszystkie te technologie są nadal wymieniane przez AVEVA jako aktualne technologie developerskie PI System.
W architekturach hybrydowych coraz większą rolę pełni CONNECT data services. Aktualne nazewnictwo AVEVA wykorzystuje właśnie określenie CONNECT data services; starszą nazwę AVEVA Data Hub lepiej pomijać w nowych materiałach. Usługa jest natywnie integrowana z PI System i służy do udostępniania kontekstualizowanych danych operacyjnych aplikacjom, analityce oraz narzędziom data science w chmurze.
Organizacja może dzięki temu rozwijać istniejący PI System stopniowo. Dane pozostające w zakładzie nadal mogą obsługiwać bieżącą pracę operatorów i inżynierów, a wybrane informacje mogą być udostępniane systemom biznesowym lub usługom chmurowym zgodnie z przyjętą architekturą IT/OT.
Rozwój PI System warto rozpocząć od konkretnego problemu operacyjnego
Jeżeli PI System działa w przedsiębiorstwie od kilku lat, punktem wyjścia powinno być sprawdzenie obecnego środowiska i wybranie zastosowania, którego efekt da się zweryfikować.
W praktyce taki proces można podzielić na cztery etapy:
- Ocena środowiska. Sprawdzane są wersje i status wsparcia komponentów, architektura akwizycji, mechanizmy zapewniające ciągłość przesyłania danych, ustawienia punktów, jakość opisów oraz stopień wykorzystania Asset Framework.
- Wybór problemu. Zespół określa konkretne pytanie operacyjne, na przykład zużycie energii na jednostkę produkcji, analizę postojów, monitoring rozruchów lub zachowanie krytycznej klasy urządzeń.
- Budowa modelu i analityki. W zakresie wymaganym przez przypadek użycia powstają struktury AF, szablony, obliczenia, Event Frames oraz widoki PI Vision.
- Walidacja i rozwój. Użytkownicy sprawdzają, czy uzyskana informacja pomaga im podejmować decyzje. Dopiero zweryfikowany wzorzec jest przenoszony na kolejne urządzenia, linie lub lokalizacje.
Takie podejście ogranicza zakres pierwszego etapu i jednocześnie pozwala sprawdzić, czy problem organizacji rzeczywiście można rozwiązać danymi, które już znajdują się w PI System.
W projektach, które realizujemy, bardzo często okazuje się, że przedsiębiorstwo posiada znaczną część potrzebnych danych. Najwięcej pracy wymaga ich uporządkowanie, powiązanie z właściwymi aktywami oraz zbudowanie logiki opisującej proces w sposób zrozumiały dla jego użytkowników.
Dla mnie właśnie w tym miejscu AVEVA PI System pokazuje największą wartość. Historia procesu zaczyna służyć technologom, operatorom, utrzymaniu ruchu, energetykom i osobom zarządzającym do odpowiadania na pytania, które wcześniej wymagały ręcznego zbierania informacji z wielu źródeł.
Jeżeli firma posiada PI System i chce ocenić poziom wykorzystania swojego środowiska, dobrym punktem startu jest jedno konkretne pytanie operacyjne: jakiej informacji o swojej instalacji potrzebujemy dzisiaj, a mimo posiadania danych nadal nie potrafimy uzyskać wystarczająco szybko?
